


汕头少年杨植麟两度创业,创立月之暗面,把开源模型做到了全球参数最大
杨植麟1992年出生在广东汕头。2011年考进清华大学热能工程系,大二转到计算机系,2015年以专业第一名的成绩毕业。随后赴美进卡内基梅隆大学读博,导师是时任苹果首任AI研究负责人的Russ Salakhutdinov和时任谷歌首席科学家的William Cohen。这个项目通常要读六年,他四年读完。
读博期间他进了谷歌大脑和Meta的AI研究院实习,作为核心成员参与了两项后来被反复引用的工作:Transformer-XL和XLNet。这两篇论文的引用次数都超过了两次万次,对一个在读博士生来说极不寻常。《财富》把他列进中国40位40岁以下商界精英时给的评语是:中国35岁以下自然语言处理领域被引用最多的研究者。
他的第一次创业在2016年,与朋友合伙创办循环智能,做面向企业的AI服务,2020年拿到红杉中国领投的1200万美元,还与华为云联合研发过大模型。苹果当时给他发过邀请,他拒了,理由后来由他的导师转述:”倘若不主动尝试创业,以后一定会遗憾。”
2023年春天,他在国内再次出发,与张宇韬、周昕宇、吴育昕几位清华校友共同创立月之暗面,英文名叫Moonshot——指向登月计划那种高风险高回报的豪赌,说的是通用人工智能。中文名的来处轻松一些:创始团队都喜欢平克·弗洛伊德那张《月之暗面》。公司主体注册在北京,全称里带着”科技”两个字,员工规模到2026年也只有三百多人,比同行少了一个数量级。
一个切口:先让别人读得动长文档
2023年10月9日,Kimi以”能读20万汉字的智能助手”露面。当时的国内环境是:ChatGPT刚把大模型变成公共话题,各家都在做通用对话,而Kimi只解决一个很窄的痛点——把长文件塞进去,让它无损读完整篇。法律合同、券商研报、博士论文、几十万字小说,这些场景此前没人照顾。11月中旬产品全面开放,用户开始涌入。
2024年3月,他们把上限推到200万字无损上下文,做内测。结果流量直接把服务打不稳定,只能紧急扩容。同年7月,上下文缓存功能公测,官方给出的说法是API价格不变的前提下,帮开发者把长文本使用成本最多降低90%。7月8日上线浏览器插件,就两个按钮:划选文字出现的”点问笔”,和挂在网页右下角的”总结器”。9月,会员订阅分49、99、199元三档开卖。
资本在这一年密集进场。2024年2月,阿里巴巴领投的A轮超过10亿美元,投后估值25亿美元,阿里在A+轮以约8亿美元拿到约36%股权,一度是单一最大股东。5月B轮把估值抬到30亿,8月再加超3亿美元,估值33亿。到2025年12月C轮5亿美元,估值43亿美元——这个数字在半年后会显得非常便宜。
开源这条路线是怎么选上的
2025年7月,Kimi K2发布并开源。这是个1万亿参数的混合专家模型,每个词元只激活320亿参数,权重直接放到开源模型托管平台上,任何人可以下载、微调、自部署。
这一步在当时不算主流。国内多数厂商把最好的模型锁在自家API后面,海外头部玩家则完全不开源。选择放开的理由,杨植麟后来讲得很直接:最强的能力放在自己手里,行业讨论就会变成”你的模型能做什么”;把权重给出去,讨论才会变成”你的方法能不能复现”。
2025年9月25日,他们上线了OK Computer——一个跑在K2上的智能体功能,能自主列任务清单、搜索网页、生成素材、写代码并检查,交付可交互可复用的结果,具体场景是搭网站、做PPT、处理百万行数据。11月,带推理链的K2 Thinking发布。这两款产品当时没引起太大波澜,但已经能看出后来的方向:模型不再只是回答问题,而是把活干完。
一百个子智能体同时干活
2026年1月27日,K2.5发布并开源。这是个1万亿参数的混合专家模型,配一个4亿参数的MoonViT视觉编码器,在K2的检查点上用15万亿词元继续预训练,再走监督微调与强化学习。真正的新东西是智能体集群:模型可以自主创建并调度最多100个子智能体并行工作,单次任务支持1500次工具调用,无需任何预设规则——谁干什么、拆成几块,全由模型当场决定。
驾驭这种并发靠的是一种叫并行智能体强化学习的训练法。团队要解决的三个麻烦是训练不稳定、功劳算不清,以及所谓的”串行崩溃”:协调者嘴上说有并行能力,实际还是一个个排队跑。解决办法是分阶段奖励——训练早期鼓励它开更多的子智能体,后期再压任务质量,同时把子智能体的参数冻住,只训练协调器。官方给的效果是端到端执行时间最多减少4.5倍。演示案例很直观:让它找出100个不同细分领域里排名前三的内容创作者,模型真的开了100个子智能体分头查,最后汇总成一张结构化的表。
在检索类评测上,它超过了对手;吴恩达在自己的通讯里点评说,这把任务执行从思维链推理升级成了”智能体团队的协作”,模型不再是顺序响应提示,而是同时充当工作流的管理者。产品端给了四种模式:即时、思考、智能体、智能体集群,最后一种先是研究预览,只对付费用户开放。
同年4月的K2.6继续开源,多项基准持平或超越海外闭源模型,在聚合评测中位列全球第九。这套每三个月迭代一次的节奏,成了公司的固定节拍。
3万亿级参数,价格是对手的十分之几
2026年7月16日,K3发布,参数规模2.8万亿,全面开源,成为全球参数规模最大的开源模型。发布后48小时,用户请求量逼近集群承载极限。黄仁勋公开说”中国模型非常出色”,马斯克在产品动态下面留了两个字:出色。
9月,K3上了亚马逊云科技的模型服务,成为中国大模型公司里第一个以收入分成模式入驻全球头部公有云的模型。同月推出企业合作伙伴计划,部分合作按推理收入分成,同时发布金融行业解决方案。
10月24日凌晨,K3.1 Pro上线。它不是从头训练的新模型,而是K3的后训练版本——大幅增加后训练算力,把强化学习扩展到数百个下游领域。总参数2.8万亿(官方称”3万亿级”),每个词元激活1040亿参数,支持100万词元上下文,原生具备视觉理解。官方说法是:价格只有对手旗舰闭源模型的五分之一,完整权重在11月4日前放出。
数字比形容词可靠。在考察真实终端受限任务的Terminal-Bench 4.0上,它得65.7%,超过对手闭源旗舰的58.2%,与另一家闭源旗舰的66.4%只差一点点。它能直接操作Unity、Unreal、Godot这些游戏引擎,写Blender和CAD脚本做参数化建模,在BenchCAD上借助工具拿到92.7%。金融方向上,从检索资料、跨文档核对数据,到搭财务模型做盈利分析,可以端到端交付,在OfficeQA Pro v2上拿到64.4的当前最优成绩。
有一项数据反而更值得看。内部的事实准确性压力测试里,单项事实陈述错误率从K3的23.4%降到8.3%,含至少一处事实错误的回答比例只剩前代的四成多。团队特意说明:这个测试刻意挑容易出错的情形做,数字不代表日常使用整体水平。愿意把这种测试单独拿出来讲,在发布会文化里不多见。
安全上,团队公开了两条原则:不发布推进网络攻防能力绝对前沿的开放权重;开放权重里可用的网络攻防能力会渐进式提升。他们的论证是,渐进式扩散比长期集中在少数闭源系统里,最终会让所有软件更安全。
输入框下面那一排按钮
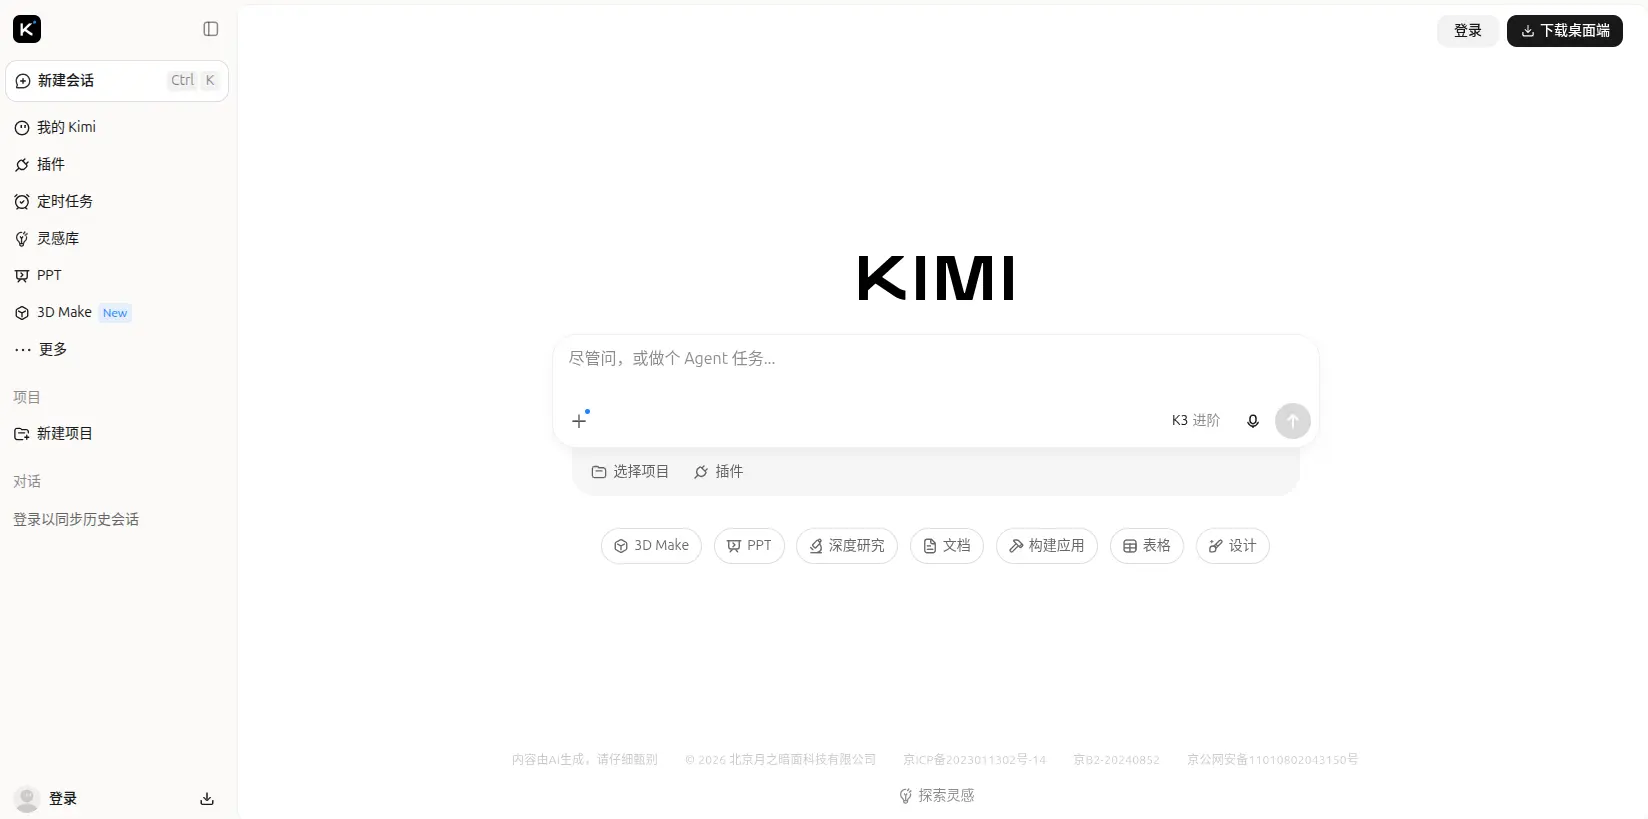
今天打开这个产品,左侧一列是新建会话、我的Kimi、插件、定时任务、灵感库、PPT、三维建模、项目;中间一个输入框,提示语是”尽管问,或做个 Agent 任务”,模型档位写着”K3 进阶”。输入框下面一排快捷入口:三维建模、PPT、深度研究、文档、构建应用、表格、设计。最底下那行小字是”内容由AI生成,请仔细甄别”,再往下是备案信息和公司全称。
这一排按钮其实是产品哲学的说明书。PPT入口背后是由K3驱动的演示文稿生成器,会自己做信息收集、图片生成、图像处理,交付可在线编辑的成品,支持上传现有文件当模板继续改,也能把图片转成可编辑格式;改完一键导出,用办公软件打开时样式不变。三维建模入口对应K3.1 Pro那套能力:给一段文字、一张草图或一张参考图,它推断形状比例与空间关系,直接操作建模软件做出可用模型,可以在线预览编辑,下载后还能拿去打印。
桌面端另有一款叫Kimi Work的本地应用,Mac和Windows都有。它和网页版是互补关系:网页版是随手问、做研究、生内容的最快入口,桌面版则能读写本地文件、运行命令、通过网页桥接直接操作浏览器、跑定时任务,最多同时调用300个智能体。它有个目标模式,把一个目标存成持续状态,每一轮结束时自己判断是完成了、卡住了还是可以进下一轮,只要电脑开着就能跨轮次跑下去。官方给的目标写法是:结果加验收证据加范围约束加预算限制加失败时怎么办。
这套东西合起来看,重心早就从”聊天”挪开了。它要的不是你多问几句,而是把一个需要好几小时的活儿接过去,交回成品。
半年涨十倍的估值
钱的节奏比模型还快。
2025年底估值43亿美元。2026年1月到2月,连续完成三轮融资,分别为5亿、7亿、7亿美元,估值从100亿冲到180亿。5月D轮约20亿美元,估值破200亿。6月E轮投前315亿。7月F轮超35亿美元,投后350亿,认购金额超出原定目标3倍以上,提前关闭。9月,以保密形式向港交所递交A1上市申请,公司对外只说”不予置评”。10月,据彭博社援引知情人士,IPO前最后一轮私募完成,估值约500亿美元,中金公司与高盛任联席保荐人,拟最早2027年第一季度挂牌。到11月,市场还在传它推进新一轮20亿美元融资。
截至7月,累计公开披露的融资超过376亿元人民币,是国内大模型创业公司里筹得最多的。股东名单很能说明问题:阿里、腾讯、美团、小红书、中国移动这样的产业方,IDG、真格、红杉中国这样的机构,还有社保基金、国智投、北京市人工智能产业投资基金这类”国家队”资金。经过多轮稀释,到7月创始团队的自然人持股仍在65%以上——阿里那36%早已被摊薄。
收入端同样陡。K3上线后日销售额猛增6倍以上。年度经常性收入3月初破1亿美元,4月翻倍到2亿,6月中旬3亿,8月年化突破10亿美元,年底目标20亿。2026年1月,个人付费订单量环比增长8280%,2月再涨123.8%,连续20天的收入超过2025年全年,海外收入反超国内。API收入增长400%,海外付费用户增长400%,服务覆盖200多个国家和地区。企业端占收入主力,超过七成来自API调用。创始人对外表态过账上现金超100亿元,短期不着急上市——半年后,上市时间表已经提前。
算力这道墙
增长的另一面是挤。
2026年2月,因为算力告急,服务出现过间歇性”罢工”。7月20日,产品发布公告,暂停个人端的新用户订阅。公告没解释细节,外界的解读高度一致:不是不想卖,是撑不住。7月那次K3发布后48小时请求量逼近集群极限,同一个逻辑。
这也解释了为什么它选择开源、选择把价格压到对手的五分之一、选择把推理搬进公有云伙伴的平台。开源看似是理想主义,实际上同时解决了三件事:让外部社区替你验证安全性、在全球开发者里换分发、把自家集群的压力分出去。入驻亚马逊的模型服务并采用收入分成,同样是把扩容这件事交给更擅长的人。
公司明确不提供私有化部署,核心战略是持续打磨模型基础能力。这句话的意思其实很硬:不做项目、不堆交付人力、不接定制需求,把资源全押在训练和推理基础设施上。三百多人的公司能撑起千亿美元级估值,靠的就是这种拒绝。
从K4到K100
杨植麟说过一个听起来夸张的规划:未来十年、二十年内陆续推出K4至K100系列。这不是玩笑式表态,而是它整个技术叙事的基础假设——能力靠规模与强化学习持续堆出来,模型变强之后,成本自然下降,应用自然长出来。招股相关报道里那组数字是这个逻辑的注脚:模型迭代节奏保持在约每三个月一次,每一次能力上台阶,收入跟着跳一档。
但这个假设也要花钱。算力采购、集群扩容、后训练的强化学习投入,都是天文数字,而这些钱相当一部分来自那些估值一年内涨十倍的融资。一旦某一代模型的边际提升撑不起下一轮融资的定价,故事就得改写。
它面对的具体问题也更难答。智能体集群能并行调度100个子智能体,那么出错时责任怎么归?模型自己决定任务拆解和角色分配,那么人类怎么审计它的判断?开源权重放到平台上,那么被拿去做坏事时,那两条”不发布攻防前沿权重、渐进式释放能力”的原则能起多大作用?公司把这些写成了原则,但没有给出可以外部检验的流程——这一点和它某些海外同行把风险报告一页页公开的做法,仍有效率与透明之间的取舍差异。
回看这家公司做的事情,其实只有一条主线:先用一个别人没做的窄切口(长文档)拿到用户,再用开源换信任和全球分发,最后用智能体把”回答”换成”交付”。它的网页上没有花哨的转化漏斗,输入框下面那一排按钮(PPT、表格、三维建模、构建应用)比任何一句广告语都更清楚地交代了它想干什么——不是做一个更聪明的聊天框,而是让模型把一份能用的东西交到你手上。
至于那堵算力墙和那份上市时间表能不能同时成立,2027年第一季度的港交所会给答案。
本站收录的Kimi相关链接均来源于网络,仅供参考。本站不保证其准确性、完整性,也不控制其指向及内容。该链接于2026年11月12日 上午9:39收录,收录时内容合规合法;若后续出现违规,请联系管理员删除!COONAV电商运营导航不承担相关责任。
同类网站


收录运营常用工具、整合运营优质资源。
 桂公网安备45112102000027号 | 桂ICP备12007265号-11 | 全站托管于阿里云