

Shapecatcher:一个你不知道字符叫什么时该去的地方
有时候你会遇到一个字符,你知道它长什么样,但不知道它叫什么名字。可能是论文里的某个数学符号,可能是别人发来的一段文本里夹着的奇怪图形,也可能是你在某个设计稿上看到一个像是某种语言的字母,但完全不知道它属于哪个字符集。这种时候,你没法在搜索引擎里输入它——因为你根本打不出来。
Shapecatcher 就是为解决这个问题做的。它的使用方式极其简单:页面上有一个画框,你用手绘的方式把你看到的字符画出来,点一下“Recognize”,网站就会返回一组最相似的Unicode字符候选,按相似度从高到低排列。不需要你知道字符的名字,不需要你了解Unicode编码,甚至不需要你画得很精确——画个大概轮廓就行。
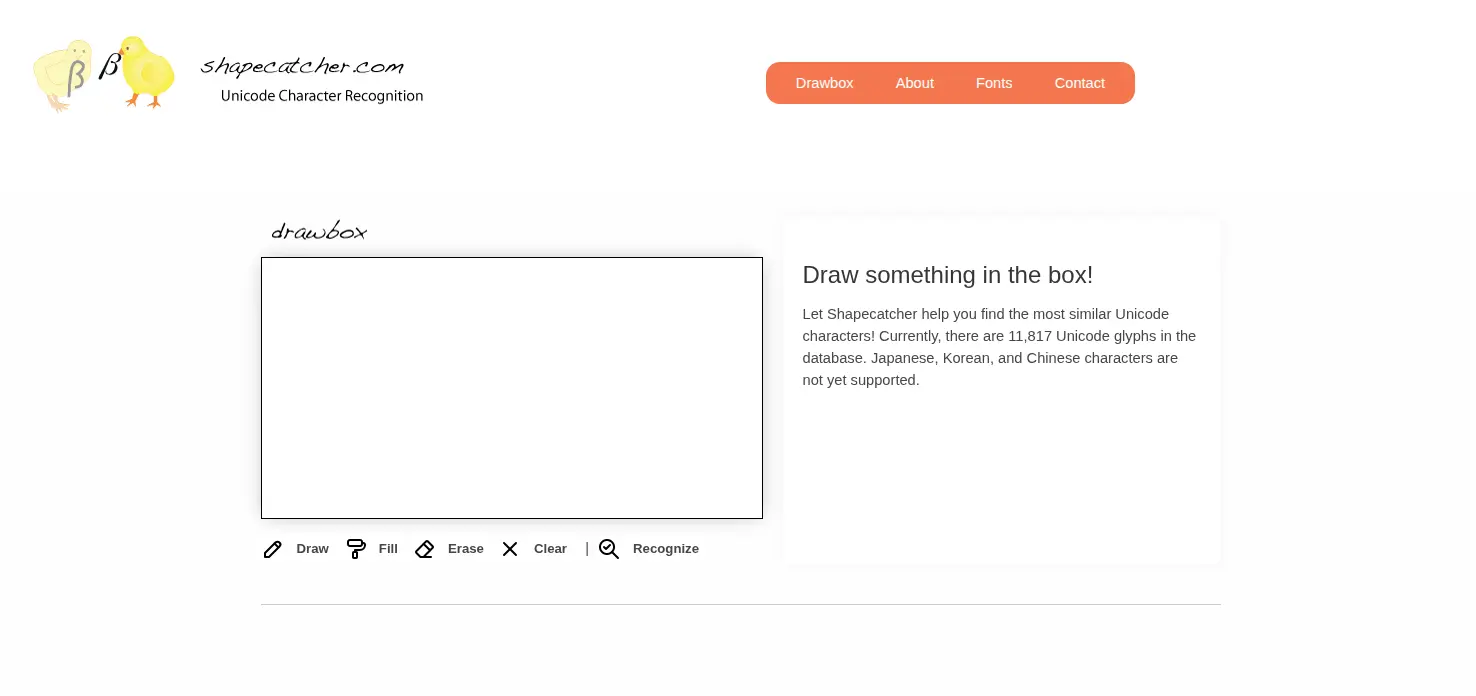
Shapecatcher官网首页插图
这个网站2011年8月上线,由Benjamin Milde开发并维护至今。它不是一个商业产品,页面上没有广告,也没有付费墙,作者在“关于”页面里写得很清楚,这个引擎是他本科论文项目的重写版本。
背后的技术:形状上下文和一块显卡
Shapecatcher的核心算法叫“shape contexts”(形状上下文),这是一种描述形状相似度的数学方法,最早由Serge Belongie和Jitendra Malik在2000年提出。简单说,它的思路不是逐像素比对,而是把形状分解成一组局部特征——每个点的位置、它周围其他点的分布模式——然后用这些特征来判断两个形状有多像。这种方法的好处是对轻微的形变和手绘误差有一定的容忍度,你用鼠标歪歪扭扭画出来的符号,跟字体库里规规矩矩的字符之间,还是能找到相似性。
有一个技术细节值得提一下。为了让比较过程足够快,作者用了CUDA来加速计算,每一张显卡处理一次查询,速度比纯CPU快了超过15倍。这意味着你在画框里画完点“Recognize”之后,结果几乎是实时出来的,不需要等服务器慢慢算。对于一个个人维护的网站来说,这个实现方式挺务实的。
数据库里有什么,没有什么
网站目前收录的字符库有11817个Unicode字形。覆盖的范围包括拉丁字母及其扩展、希腊字母、西里尔字母、阿拉伯字母、希伯来字母、各种数学符号、箭头、几何图形,以及一部分日文假名(平假名和片假名)。
但中文、日文汉字和韩文不在支持范围内。作者在网站早期就解释过原因:找不到一款足够好的免费CJK字体来生成可用的字符形状数据。这个限制在实际使用中影响不小——很多人想找的恰恰是那些不认识的汉字或者日文汉字。作者后来提到Google做Noto字体之后情况可能有所改善,但截至目前的公开信息,CJK字符仍然没有被纳入数据库。
实际用起来的一些经验
从用户分享的使用经验来看,有几点比较实用。第一是别追求画得“对”,追求画得“像”。手绘的线条稍微歪一点、比例不太对,都不太影响结果,算法更关注的是整体轮廓和笔画之间的相对位置关系。第二是如果第一次的结果不太对,可以试着用不同的风格重画一次——比如把某个符号画得稍微大一点、笔画画得粗一点——有时候换一种画法能让匹配结果完全不同。第三,Shapecatcher返回的结果只是一组候选,它不保证第一个就是你要找的,需要你自己在结果列表里翻一翻,看看哪个跟你印象中的字符对得上。
有一个在Stack Exchange上被提到的“隐藏用法”挺有意思:如果你画一个矩形,返回的结果会显示出当前字体库里缺失了哪些字符。这原本是开发者用来调试字体覆盖率的办法,但普通用户也可以借此了解某个字体到底支持多少Unicode字符。
它在一个什么样的位置上
跟Shapecatcher做类似事情的工具不止一个。Detexify专门面向LaTeX数学符号的手写识别,在学术圈里用得更多。GNOME Characters应用也内置了手绘搜索功能。但Shapecatcher的特点在于它的覆盖面更宽——不只是数学符号,还包括各种字母系统的符号、标点、几何图形等,而且它完全基于网页,不用安装任何东西。
有人在社交平台上说,每次用Shapecatcher的时候都很感激开发者做了这个东西并且一直在维护。对于一个没有商业模式、靠一个人撑了十几年的工具站来说,这种评价算是很实在的认可。它的使用场景其实很窄——一年可能也用不了几次——但每次用到的时候,你找不到别的什么东西能替代它。
本站收录的Shapecatcher在线字符识别工具相关链接均来源于网络,仅供参考。本站不保证其准确性、完整性,也不控制其指向及内容。该链接于2026年9月29日 下午4:19收录,收录时内容合规合法;若后续出现违规,请联系管理员删除!COONAV电商运营导航不承担相关责任。
相关导航


收录运营常用工具、整合运营优质资源。

 桂公网安备45112102000027号 | 桂ICP备12007265号-11 | 全站托管于阿里云