

WeKnora:微信团队开源的企业知识底座,正在从“能问答”走向“能办事”
腾讯开源的项目不少,但 WeKnora 的出身比较特殊。它源自微信对话开放平台的核心技术框架,官网挂在 weknora.weixin.qq.com,Docker 镜像发布在 wechatopenai 命名空间下。换句话说,这不是腾讯 AI Lab 的实验性项目,而是经过真实生产验证的企业级产品,只是被开源了出来。
WeKnora(维娜拉)的名字可以拆成 We Know Ra,定位是一句话:把原始文档变成可查询的 RAG、自主推理的 Agent、自维护的 Wiki。这个“三合一”的设计,是它和其他开源 RAG 项目最本质的区别。
三合一:查知识、做任务、沉淀资产
大多数开源 RAG 项目只做一件事:文档入库、检索、生成回答。WeKnora 把知识工作的三个层次装进了同一个平台。
第一层是 RAG 快速问答。 面向“查东西”的轻量场景,文档解析后建立索引,用户提问时检索相关片段,大模型生成带引用标注的回答。这部分能力是基础,但 WeKnora 的检索策略比多数同类项目更精细——不是单一向量检索,而是 BM25 稀疏检索加稠密向量检索的混合方案,配合 RRF 融合和 Rerank 重排,口语化提问也能命中相关内容。
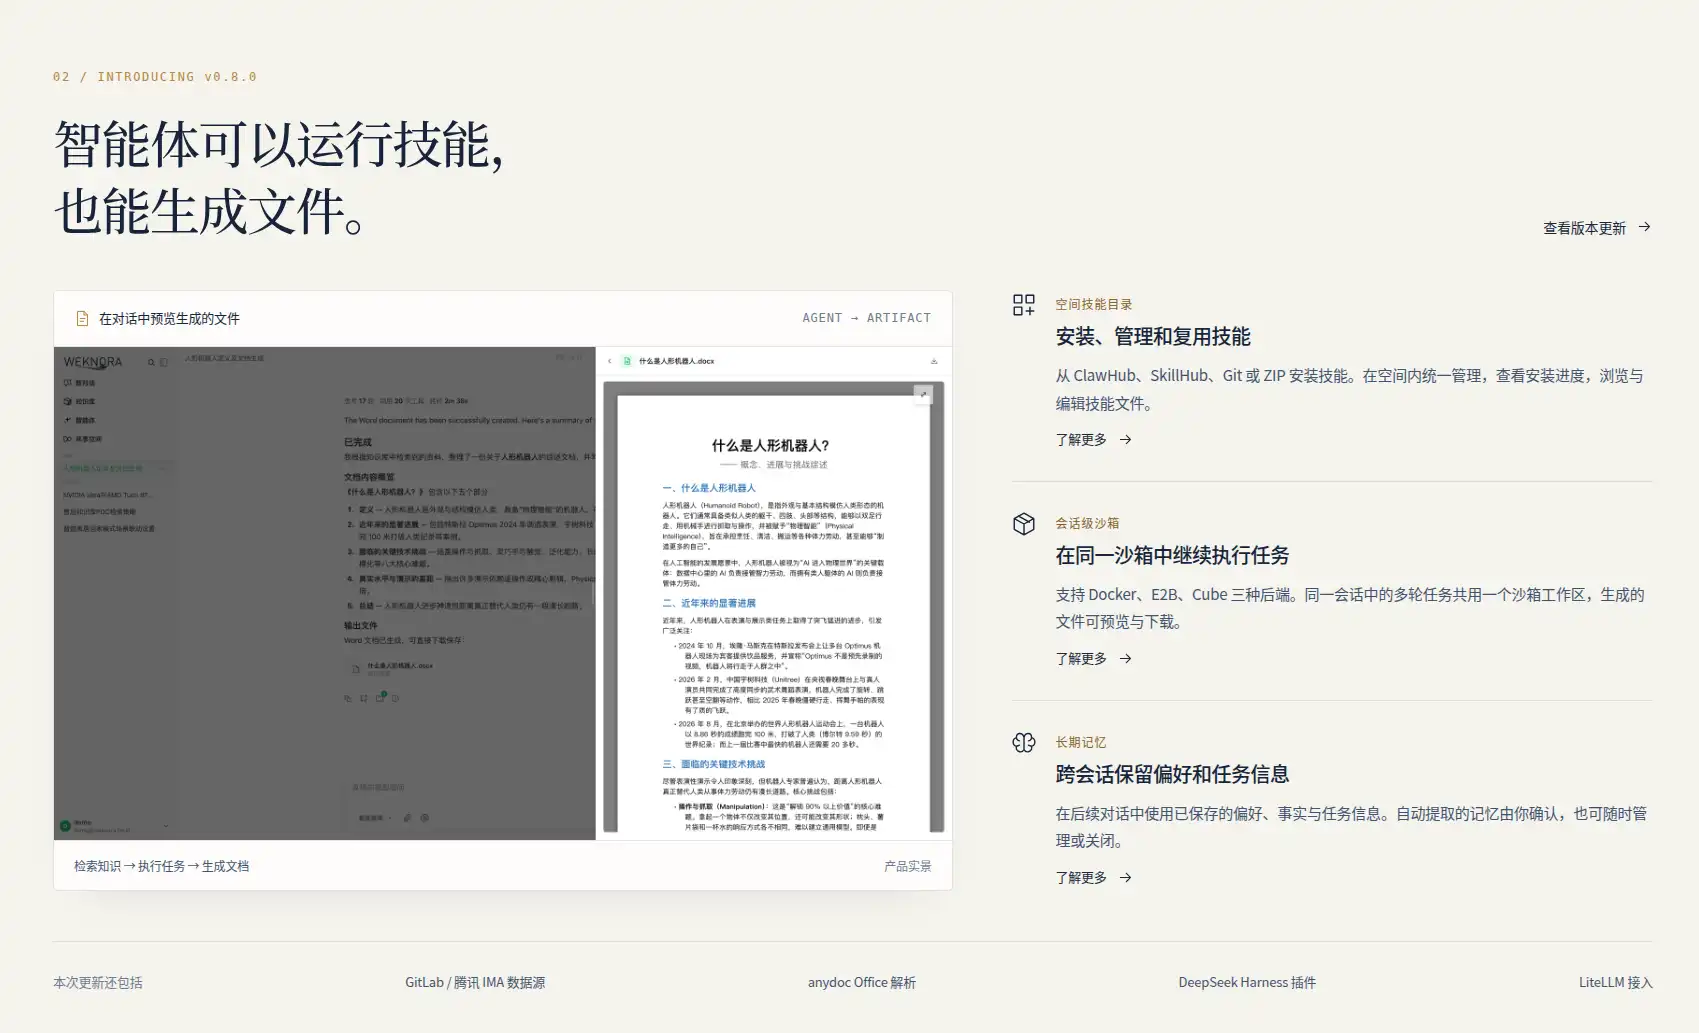
第二层是 ReAct Agent。 这不只是“检索+回答”,而是能自主编排多步任务。遇到“对比 Q2 与 Q3 营收数据,分析变化原因”这类需要综合多源信息的问题,Agent 会主动拆解:先检索知识库,再调用 MCP 工具查数据,必要时联网搜索,经过“思考—行动—观察”的循环后给出综合答案。v0.8.0 还加入了会话级沙箱,Agent 可以在隔离环境里执行代码、读写文件、跑数据分析,生成的图表和文档直接归集到对话里预览下载。
第三层是 Wiki 模式。 这是 WeKnora 在同类产品里独有的功能,Dify、RAGFlow、FastGPT 都没有。Agent 把原始文档蒸馏成互相链接的 Markdown 知识页面,自动建立关联,附带交互式知识图谱。知识页面支持手动编辑、版本对比和一键回滚。这个能力的价值在于,它把“文档维护”这件持续消耗人力的事,变成了 Agent 的日常动作。
工程实现:Go 后端和一个独立的文档解析服务
WeKnora 的技术栈在同类项目里比较特别。主后端用的是 Go(gin + GORM + asynq),而不是 RAG 领域更常见的 Python。文档解析被拆成了一个独立的 Python gRPC 微服务 docreader,专门负责文件格式转换、OCR 识别和图片提取。
这个拆分有实际意义。文档解析是 RAG 管线里最“脏”的环节——PDF 版式分析、扫描件 OCR、表格抽取、图片多模态描述,每个格式都有各自的坑。把它独立出来,意味着可以单独升级解析能力而不影响主服务的稳定性。docreader 目前支持 25 个以上的解析器,覆盖 PDF、Word、Excel、PPT、Markdown、HTML、EPUB、图片、音频等格式,XMind 也在 v0.8.0 里加入了支持。
存储层面,WeKnora 的默认选择是 ParadeDB——PostgreSQL 17 加上 BM25 扩展和 pgvector。这意味着开箱就有“关键词检索 + 向量检索”的混合能力,不需要单独部署向量库。同时它也支持 Elasticsearch、Milvus、Weaviate、Qdrant 等七种向量数据库作为替代或叠加方案。
文档摄入走异步任务队列,六个 worker 池分别处理核心流程、后处理、富化、维护、共享和 Wiki 生成。分块策略支持父子切分——先粗粒度定位章节,再细粒度提取内容,这是提升长文档 RAG 效果的关键技巧。
v0.8.0 的三个变化:记忆、沙箱、技能
WeKnora 的迭代节奏很快,v0.8.0 是最近一次比较重要的更新,端上来了三件大事。
跨会话长期记忆。 之前 WeKnora 的会话记忆只在当前窗口有效,窗口一关,模型就不知道用户偏好的输出格式,也不记得上周强调过的业务事实。v0.8.0 按用户维度把记忆分成五类:用户画像、操作偏好、客观事实、待办事项、长期兴趣。常驻的画像和偏好自动融入每轮回答,事实和待办按需召回,长期兴趣参与文档亲和度加权——系统能感知用户反复查阅的核心文献,在向量检索阶段给它们更高的个性化权重。
有一个设计细节值得注意:后台提取器可以从日常对话中自动推断记忆项,但推断出的内容默认进入“观察中”状态,必须由用户确认后才正式生效。这个“确认制”避免了 AI 自作主张记住错误信息的风险。长期记忆默认关闭,需要在空间设置里显式开启。
运行时沙箱。 Agent 执行代码这件事,之前 WeKnora 的处理方式比较粗糙——直接在主机的本地进程里跑。风险显而易见:文件误删、依赖污染、敏感数据外传。v0.8.0 把技能执行彻底搬进了会话级持久化沙箱,同一会话里的终端命令、文件读写和最终产物都在隔离工作区里共享,会话结束容器回收。后端支持 Docker(单机私有化最省事)、E2B(云端/自托管控制面)和 Cube Sandbox(远端控制面)三种运行时。
安全边界做了多层:容器内以非 Root 用户执行,阻断提权和路径逃逸;出网策略默认阻断外网,只允许域名白名单;CPU/内存限额和生命周期 TTL 按租户配置。
技能市场。 以前给 Agent 加一个业务技能,需要手写 SKILL.md、同步到服务器目录、重启应用、再给智能体勾选,全程人肉操作。v0.8.0 把技能升级为工作空间里的一等公民资产,进了租户级技能市场。来源包括 ClawHub、SkillHub、GitHub/GitLab 链接和本地 ZIP,安装过程有流式日志和版本快照。装好后管理员决定哪个 Agent 能访问哪些 Skill,能力从“每次临时发挥”变成“可审查、可复用、可分发的模块”。
技能的加载方式是按需的:模型先看技能名和简介,匹配到任务后才读取详细说明和文件,不占 token 也不干扰上下文。
IM 集成:一个容易被忽略的差异点
WeKnora 支持通过企业微信、飞书、钉钉、QQ、Slack、Telegram、Mattermost、微信等十个 IM 渠道直接提供问答服务。这个能力在开源 RAG 项目里很少见,但对于企业场景来说价值很大——员工不需要打开一个专门的 Web 页面来查知识库,在平时工作的 IM 工具里直接问就行。
数据源方面,它支持飞书 Wiki、飞书 Drive、GitLab、腾讯 IMA、Notion、语雀、钉钉文档和 RSS 的定时同步。团队的知识如果散落在这些平台里,可以自动汇聚到统一的 WeKnora 知识库中。
部署和选型
WeKnora 的部署方式比较全:Docker Compose 默认推荐,Kubernetes 用 Helm chart,裸机有 systemd units,macOS 有 Homebrew,还有桌面应用(Wails v2)和 WeKnora Cloud 托管版。
Lite 模式值得单独提一句。用 sqlite + 内嵌 sqlite-vec 替代 PostgreSQL 和 Redis,单二进制带内嵌前端,不需要额外部署数据库和队列服务。对于个人使用或小团队测试来说,这个模式的启动成本很低。
如果你需要的是深度文档理解加企业级知识库,WeKnora 和 RAGFlow 都在选项里。如果团队在用企微或飞书,需要 IM 渠道集成,WeKnora 是差异最明显的选择。如果需要 Wiki 模式做长期知识沉淀,目前开源项目里只有 WeKnora 提供了带版本控制的完整实现。
WeKnora 不是最轻的,也不是最偏算法研究的开源 RAG 项目。但它在“真正能落到企业里”这件事上,做得比多数同类项目更完整。从长记忆到沙箱到技能市场,v0.8.0 把它从“一个能运营的知识系统”推向了“一个带记忆、能执行、可扩展的 Agent 知识底座”。方向是清楚的,剩下的交给时间和版本稳定性来验证。
本站收录的WeKnora相关链接均来源于网络,仅供参考。本站不保证其准确性、完整性,也不控制其指向及内容。该链接于2026年9月17日 上午9:33收录,收录时内容合规合法;若后续出现违规,请联系管理员删除!COONAV电商运营导航不承担相关责任。
相关导航


收录运营常用工具、整合运营优质资源。

 桂公网安备45112102000027号 | 桂ICP备12007265号-11 | 全站托管于阿里云